执行长时间BMC重启,概率出现Disk12 SN替换日志

问题现象

BMC重启,Disk12会出现SN替换的SEL日志,实际上环境没有人动。
分析后发现,Disk12的信息先是Nvme盘的信息,后被替换成SATA盘。Disk12实质上是Nvme盘,但是因为get_pd_list获取到的有异常的pd对象,一直没有被绑定到实质的物理盘上。测试跑长时间之前触发了Nvme盘Web点灯,导致这个pd被绑定到Nvme上,进而刷新了Nvme盘的信息。
这里有两个解释不清楚的地方
1: 异常的pd对象是从哪里来的?为什么get_pd_list和compare没法消除掉;
2:异常的pd绑定到Nvme盘后,从哪里获取的SATA盘信息,刷新到了Nvme盘上?刷新出来的信息经过与测试对齐,是不在环境上的。

信息1:BMC时间+8对应自动化时间

信息2:Disk12是Nvme盘。

pcie_type读取出来一直是1(Nvme),而且对象加载次数与其它Nvme盘保持一致,非常稳定。这对BMC重启产生的概率性问题无影响,基本肯定是Nvme盘。

image 3

Nvme盘的信息:

“ModelNumber”: “SAMSUNG MZWL63T8HFLT-00B07”,
“SerialNumber”: “S7LZNG0Y200253”,
“FirmwareRev”: “LDD5902Q”,
“PCIVendorID”: “0x144d”,
“PCIVendorSubsystemID”: “0x144d”,
“IEEEOUIIdentifier”: “0x002538”,
“Manufacturer”: “Samsung”,
“SerialNumber”: “N/A”,
“Model”: “SAMSUNG MZWL63T8HFLT-00B07”,

Disk2(0:36:37:0)绑定的SATA盘的信息:

Device Name : Disk9
Manufacturer : TOSHIBA
Serial Number : 20G0A23MFDWG
Model : AL15SEB120N
Firmware Version : 0807
Health Status : Normal
Firmware State : ONLINE
Power State : Spun Up
Media Type : HDD
Interface Type : SAS
Capable Speed : 12.0 Gbps
Negotiated Speed : 12.0 Gbps
Drive Temperature : 36
Capacity : 1.092 TB

信息3:Nvme盘和误产生的SATA盘的信息如下:

异常的SN:20G0A23MFDWG,东芝盘

正常的SN:S7LZNG0Y200253,三星Nvme盘。

2026-06-09 19:35:32.128770 frudata NOTICE: sn_replace.lua(62): BoardSerialNumber changed from 20G0A23MFDWG to S7LZNG0Y200253
2026-06-09 19:36:14.175495 frudata NOTICE: sn_replace.lua(62): BoardSerialNumber changed from S7LZNG0Y200253 to 20G0A23MFDWG

基本上启动后30-40s后,信息先刷新成S7LZNG0Y,再刷新回20G0A23

ID : 12
Device Name : Disk12
Manufacturer : Samsung
Serial Number : 20G0A23MFDWG
Model : AL15SEB120N
Firmware Version : 0807
Media Type : HDD
Interface Type : SAS

ID : 13
Device Name : Disk13
Manufacturer : Samsung
Serial Number : S7LZNG0Y200253
Model : SAMSUNG MZWL63T8HFLT-00B07
Firmware Version : LDD5902Q
Media Type : SSD
Interface Type : PCIe

信息4:

: Nvme盘被RAID卡管理,也会通过SP686C刷新信息,不单单是VPD

load nvme-mi无一例外的走入了两次,入口只有

问题4:pd在热插拔以后会触发update_pd_list函数,变成del_pd然后设置pd invalid,为什么Nvme依然能够匹配上?

总结下来:pd绑定到Nvme的直接原因是Nvme在Web上的点灯;

pd绑定的间接原因是:pd 0:36:37:0,没有实际绑定的物理盘,但是pd:invalid没有被置位,导致pd对象点灯流程一直保留,从而在后续Nvme盘手动点灯的时候被触发。

那么 0:36:37:0到底是从哪来的?为什么没能成功点灯,是因为环境上有一块坏掉的物理盘吗?

大概脉络清楚了:未知原因保留了0:36:37:0这个pd,然后触发Web Nvme点灯,从而导致Nvme盘与0:36:37:0绑定,从RAID刷新信息。后续则不依赖于Nvme点灯,直接从缓存进行绑定。

  1. 0:36:37:0是怎么来的?为什么没有这块盘,会获取到这么一个逻辑盘对象?
  2. 这块SAS盘实际上根本不存在,怎么会能够刷新信息?
  3. Nvme是如何通过数据库,与0:36:37:0进行绑定的?就是Drive对象的一些属性值是怎么来的,是不是也有持久化,也从pd更新过来的?

调试命令

复位持久化数据库地址:/opt/bmc/pram/persistence/per_reset.db

查询命令:SELECT * FROM persist_table where table_name=‘t_storage_drive’;

删除命令:DELETE FROM persist_table WHERE table_name = ‘t_storage_drive’ AND prime_key = ‘Id:7’;

DELETE FROM persist_table WHERE table_name = ‘t_storage_drive’ AND prime_key = ‘Id:5’;

整体流程梳理

2026-06-08T12:53:47:整机AC

2026-06-09 02:02:19 BMC重启

2026-06-09 02:05:27.680629 pd 0:26:30:0 add,pd对象添加完毕,没有pd 0:36:37:0

2026-06-09 02:05:47 Disk2绑定到 0:5:2:0,

2026-06-09 02:05:50.170794 0:26:30:0绑定到 Disk30

2026-06-09 02:10:30.231450 pd_identify_service.lua(186): pd 0:36:37:0 add [repeated 6 times in 0s from 2026-06-09 02:05:27.680629,显示从pd 0:26:30:0 add开始重复了很多次?!难道这个跟0:26:30:0是同一个东西?

2026-06-09T06:00:21 OS重启

2026-06-09 06:19:20 Disk2拔出,06:20:27 Disk2插入(换盘)

2026-06-09 06:20:49:0:36:37:0 pd绑定到Disk2;

2026-06-09 07:55:52之前:20G0A23MFDWG(SAS)在Disk2上,S7LZNG0Y200253在Disk12上。

2026-06-09 07:55:52触发AC,信息全部清空。

2026-06-09T07:55:58.945032+00:00 2102315PGC10S1100002 om: 3,2026-06-09 07:55:52,Normal,0x1A00000D,Asserted,iBMC is restarted after AC power supply is restored.
2026-06-09T07:56:42.944385+00:00 2102315PGC10S1100002 om: 4,2026-06-09 07:56:41,Normal,0x12000005,Asserted,Chassis cover is open.
2026-06-09T07:57:20.643976+00:00 2102315PGC10S1100002 om: 5,2026-06-09 07:57:20,Normal,0x02000023,Asserted,The disk Disk2 is replaced from SN(20G0A23MFDWG) to SN(AN3SR8XN) (SN:AN3SR8XN).

2026-06-09 07:56:53 看门狗上报,差不多RAID卡识别与逻辑盘已缓存(?)

2026-06-09 07:56:47 获取到所有的pd对象列表,开始尝试点灯。

2026-06-09 07:57:15 Disk2绑定到0:21:2:0上。

2026-06-09 07:57:15.522616 storage NOTICE: drive_object.lua(872): drive identify, pd = 0:21:2:0, drive = Disk2
2026-06-09 07:57:15.529523 storage NOTICE: pd_identify_service.lua(476): update drive2 persistence data
2026-06-09 07:57:15.530625 storage NOTICE: pd_identify_service.lua(477): update info is 0, 2, 0

2026-06-09 07:57:20 Disk2替换为另一块SAS盘。 — 应该是匹配上以后从RAID获取信息,才打印的SN变更,实际盘更换时间应该在这之前。

2026-06-09T07:57:20.643976+00:00 2102315PGC10S1100002 om: 5,2026-06-09 07:57:20,Normal,0x02000023,Asserted,The disk Disk2 is replaced from SN(20G0A23MFDWG) to SN(AN3SR8XN) (SN:AN3SR8XN).

2026-06-09 11:06:35 Nvme12 触发点灯

2026-06-09 11:06:35 WEB,Administrator@192.168.109.77,storage,Start locating Disk12 successfully
​
2026-06-09 11:06:35.064405 storage NOTICE: rpc_service_drive.lua(59): [Storage]Start SetLocationIndicatorState of Disk12
2026-06-09 11:06:35.200959 storage NOTICE: rpc_service_drive.lua(78): [Storage]Successfully SetLocationIndicatorState of Disk12.
2026-06-09 11:06:44.259641 storage NOTICE: drive_object.lua(872): drive identify, pd = 0:36:37:0, drive = Disk12
2026-06-09 11:06:44.264548 storage NOTICE: pd_identify_service.lua(476): update drive12 persistence data
2026-06-09 11:06:44.264974 storage NOTICE: pd_identify_service.lua(477): update info is 0, 37, 0

2026-06-09 12:59:50 CLI,Administrator@192.168.109.77:63042,maca,Reset BMC start

如果说这次启动pd对象已经获取到值了,然后在重启BMC以前触发了Nvme盘点灯,并且属性值有复位持久化,那就很有可能在重启以后,数据保留原先的值。

怀疑点1:pd对象的值,是否在获取pd_list后,就能有值缓存在RAID卡里?不确定SP686C的机制;

怀疑点2:硬盘信息,复位是否会丢失?印象中自验证是会丢的,还需要确认。
答案内容由AI生成,仅供参考:

总结

当前知识库未提供直接的绑定代码细节,但结合已有信息,问题很可能由以下组合原因导致:

  • BMC重启后NVMe对象初始化延迟或失败,导致临时绑定错误;
  • VPD与RAID卡信息源竞态写入,序列号被错误覆盖;
  • PD对象的无效状态未正确置位,使得点灯流程错误关联了无效PD,进而触发了持久化错误绑定。

进一步定位需深入代码层面的 pd_identify_service 和 drive_object 模块,并验证持久化数据库在重启后的行为。建议在社区论坛或相关PR中追踪该问题的修复进展。

点击此处查看详细分析解答

根据您提供的详细分析和日志,问题涉及长时间BMC重启后,NVMe盘(Disk12)的序列号被错误替换为SAS盘序列号的现象。以下结合知识库中的信息,对可能的原因和排查方向进行梳理。

可能原因(基于知识库)

  1. NVMe对象初始化时序问题
    知识库文档《冷重启多次测试后,nvme盘的BMC信息磨损率丢失问题分析》指出:

    • BMC启动过程中若NVMe设备未能及时响应或初始化超时,可能导致NVMe相关对象创建失败。
    • 冷重启可能加剧初始化时序问题,进而影响属性(如序列号)的正确加载。
      → 这可能导致NVMe盘与VPD数据之间的绑定在启动阶段出现异常。
  2. VPD与RAID卡信息的冲突

    • SerialNumber作为唯一标识,存在多来源(VPD、iBMA、RAID卡等)竞态写入的风险。知识库中提到“当硬件和软件SR文件报告不同值时,冲突出现”,这与日志中序列号在 20G0A23MFDWG 和 S7LZNG0Y200253 之间反复切换的现象一致。
    • liaozhongquan 曾质疑NVMe信息是来自iBMA还是VPD,说明信息源的不确定性是已知问题。
  3. 持久化绑定与点灯流程的交互

    • 您分析指出pd_identify_service在点灯过程中将Disk12错误绑定到 0:36:37:0(原应属于SAS盘的PD对象),导致后续从RAID卡刷新信息覆盖了NVMe的序列号。
    • 知识库中Event Common Issues Guide提到BMC告警的持久化行为(需物理重插或冷复位才能清除),可类比绑定关系持久化:若在BMC重启前错误绑定被持久化到 per_reset.db,重启后可能保留错误关联。
  4. RAID卡(SP686C)信息刷新机制的固有风险

    • 日志显示NVMe盘被RAID卡管理(通过SP686C刷新信息),而您的分析指出SAS盘的PD对象 0:36:37:0 可能因未知原因未被置为无效,从而在NVMe盘点灯时被错误匹配。
    • 知识库中关于BMC Dev NVMe Status和BMC Dev NVMe Product Info的描述表明BMC依赖VPD获取NVMe静态数据,但若RAID卡同时注入信息,可能覆盖VPD数据。

排查建议(来自知识库相关指导)

  1. 检查启动日志

    • 查看 /var/log/ibma.log 和 storage 组件日志,确认是否存在“NVME resource初始化失败”、“I2C通信超时”或“Chip_SSD_xxx访问失败”记录。
    • 重点关注冷重启后首次启动的日志,确认 LibAdapter.py 是否成功触发了NVMe resource的更新事件。
  2. 验证硬件通信链路

    • 确认NVMe背板CPLD固件为最新版本,避免CPLD通信异常导致SSD芯片(如SSDChip)访问失败(参考磨损率丢失案例)。
  3. 分析持久化数据库

    • 您已提供调试命令,建议重点检查 t_storage_drive 表中 Disk12(Id:12)的 RefDiskArrayId、SlotNumber、EnclosureId 等字段是否正确,并与实际硬件槽位对照。
    • 删除可疑的持久化条目后重新测试,验证问题是否复现。
  4. 结合 iBMA 与 VPD 的数据一致性

    • 由于NVMe信息可能同时来自iBMA和VPD,确认两边的序列号是否一致。若不一致,需按系统设计确定哪一方为权威数据源(通常VPD优先)。
  5. 与硬件 SIG 确认 RAID 卡缓存机制

    • 您怀疑 0:36:37:0 在物理盘不存在时仍被维护,建议确认RAID卡(SP686C)的PD列表缓存策略,以及BMC获取PD列表后的过滤逻辑。

总结

当前知识库未提供直接的绑定代码细节,但结合已有信息,问题很可能由以下组合原因导致:

  • BMC重启后NVMe对象初始化延迟或失败,导致临时绑定错误;
  • VPD与RAID卡信息源竞态写入,序列号被错误覆盖;
  • PD对象的无效状态未正确置位,使得点灯流程错误关联了无效PD,进而触发了持久化错误绑定。

进一步定位需深入代码层面的 pd_identify_service 和 drive_object 模块,并验证持久化数据库在重启后的行为。建议在社区论坛或相关PR中追踪该问题的修复进展。

环境早期日志:
KunLun5280V2_2102315PGC10S1100002_20260606-0049.tar.gz (9.3 MB)

长时间第六次,读取发现SN发生变更的日志:
06.tar.gz (11.9 MB)

长时间跑完后,正常环境日志:
KunLun5280V2_2102315PGC10S1100002_20260613-0933.tar.gz (9.6 MB)

提单日志:
20260610034552.tar.gz (12.9 MB)

首先raid卡点灯阶段 不能手动去点灯,会影响点灯流程。

========================================
Q1: 异常的pd对象是从哪里来的?为什么get_pd_list和compare没法消除掉?

来源:pd 0:36:37:0 是 SP686C RAID卡固件通过 sml.get_ctrl_pd_list 上报的。RAID卡固件层面对slot 37这个不存在的槽位仍返回了pd对象,这是RAID卡固件问题。

为什么compare消除不了:compare_pd_list的逻辑是对比"本次从RAID卡获取的pd_list"与"上次缓存的pd_list"。只要RAID卡每次都上报0:36:37:0,它就一直在new_pd_list里,不会被判定为del。compare只是做差集,它信任RAID卡返回的数据,没有能力判断pd是否对应真实物理盘。

========================================
Q2: 异常的pd绑定到Nvme盘后,从哪里获取的SATA盘信息,刷新到了Nvme盘上?刷新出来的信息不在环境上。

来源:绑定后通过 update_drive_common_info 周期性调用 sml.get_pd_info(ctrl_id=0, device_id=36) 向SP686C RAID卡查询。RAID卡内部缓存了之前插入过Disk2槽位的东芝SAS盘(20G0A23MFDWG)的数据,即使物理盘已拔出,RAID卡仍返回缓存的pd_info。BMC拿到后通过 on_pd_update 信号回调 update_static_drive_info,覆盖了Disk12的SN/Model/Manufacturer等属性。

这就是为什么信息不在环境上——它是RAID卡缓存的已拔出盘的历史数据。

========================================
Q3: pd在热插拔以后会触发update_pd_list函数,变成del_pd然后设置pd invalid,为什么Nvme依然能够匹配上?

关键点:热插拔触发的 update_pd_list → del_pd → invalid() 清除的是已经绑定的pd。但对于0:36:37:0这个幽灵pd:

  1. 首次出现时没有被绑定,它一直待在 pd_identify_service.pd_list 中
  2. invalid() 只在RAID卡列表中该pd消失时才调用。但RAID卡每次都上报0:36:37:0,所以它永远不会被判定为del,永远不会被invalid
  3. identify_task 每次循环取 pd_list[1],0:36:37:0 一直在队列中等待匹配

NVMe能匹配上的原因是LED误判:Web点灯使Disk12的 LocateLed=1,map_allowed 检查 is_being_located()(LocateLed==1 且 FaultLed==0)返回true。代码没有区分LED是Web SMC触发还是RAID pd触发,也没有过滤NVMe协议的盘,导致误匹配。

========================================
Q4: 0:36:37:0是怎么来的?为什么没有这块盘,会获取到这么一个逻辑盘对象?

这是SP686C RAID卡固件上报的。pd key格式为 controller_id:device_id:slot_num:enclosure_id,0:36:37:0 表示controller 0上device_id=36、slot_num=37、enclosure_id=0的pd。

日志中"pd 0:36:37:0 add [repeated 6 times from 02:05:27]"与"pd 0:26:30:0 add"时间戳一致,说明RAID卡在同一批 get_ctrl_pd_list 响应中同时返回了0:26:30:0和0:36:37:0。0:36:37:0很可能是RAID卡固件对某个RAID配置残留或背板配置错误的产物,需要拉通RAID卡固件团队确认slot 37对应什么。

========================================
Q5: 这块SAS盘实际上根本不存在,怎么会能够刷新信息?

RAID卡缓存机制:SP686C对 sml.get_pd_info 请求返回的是RAID卡内部缓存的pd信息。即使物理盘已拔出,RAID卡不会立即清除缓存,仍返回最后一次在线时的数据(东芝盘信息)。

BMC侧代码无条件信任RAID卡返回的数据:get_pd_info 成功后直接通过 on_pd_update:emit(ret) 触发 update_static_drive_info,将SN/Model/Manufacturer等覆盖到Disk12上,没有校验数据有效性。

========================================
Q6: Nvme是如何通过数据库,与0:36:37:0进行绑定的?Drive对象的一些属性值是怎么来的,是不是也有持久化,也从pd更新过来的?

两阶段绑定机制:

【阶段1 — 首次绑定(LED匹配)】
Web点灯 → Disk12.LocateLed=1 → identify_task 中 map_allowed 误判匹配 → drive:identified(pd) 设置 RefControllerId=0, SlotNumber=37, EnclosureId=0, device_id=36。然后 update_identified_data 将绑定关系写入 per_reset.db 的 t_storage_drive 表。

【阶段2 — 重启后绑定(持久化恢复)】
BMC重启后,RAID卡上报0:36:37:0 → identify_pd_by_persistence_data 查询 t_storage_drive WHERE EnclosureId=0 AND SlotNumber=37 AND RefControllerId=0 → 命中Disk12 → 直接绑定,无需LED匹配。

Drive属性值来源:是的,既有持久化也有从pd实时更新。

  • t_storage_drive表中 protect_reset 标记的字段(SlotNumber/EnclosureId/RefControllerId/Model/SerialNumber/Failure等)复位不丢失
  • 绑定后通过 on_pd_update 信号从RAID卡实时获取并更新

========================================
怀疑点1回答:pd对象的值,是否在获取pd_list后,就能有值缓存在RAID卡里?

是的。SP686C RAID卡内部维护了pd缓存。sml.get_pd_info 返回的SN/Model等信息来自RAID卡缓存,即使物理盘已拔出也不会立即清除。这是RAID卡固件的行为,BMC侧无法控制。

========================================
怀疑点2回答:硬盘信息,复位是否会丢失?

部分丢失,部分保留。storage组件持久化分两类:

  • protect_reset(复位保持):SlotNumber、EnclosureId、RefControllerId、Model、SerialNumber、PredictiveFailure、Failure等 —— AC复位不丢失
  • protect_power_off(掉电保持):CommandTimeoutTimes、FaultLogCollectCount等 —— 仅掉电保持,AC复位丢失

所以错误的绑定关系(Disk12 → 0:36:37:0)存储在 protect_reset 级别,AC复位后会恢复,这就是每次BMC重启都会出现SN替换的原因。手动清理命令:
DELETE FROM persist_table WHERE table_name = ‘t_storage_drive’ AND prime_key = ‘Id:12’;

RAID卡内部缓存的pd信息。即使物理盘已拔出,RAID卡不会立即清除缓存,仍返回最后一次在线时的数据(东芝盘信息)。
RAID卡的PD信息缓存机制能再详细一些吗?我通过手动调整代码+点灯的方式,能够复现Nvme盘绑定到Raid下,刷新成之前物理盘的信息。但是当卡拔掉然后复位BMC以后,这个信息是获取不到的,不满足当前问题的场景,所以想了解下缓存的细节。

另外最开始提的一点:RAID卡点灯阶段不能手动点灯:这个流程结束没有标志。
当前问题的情况就是有一个游离的pd对象一直点灯失败,没有相关告警和操作日志/系统日志,此时测试重新开始测试Nvme点灯以及相关流程,于是意外绑定上了。这个我觉得属于常规动作,不能算是非法操作。

0:36:37:0很可能是RAID卡固件对某个RAID配置残留或背板配置错误的产物,需要拉通RAID卡固件团队确认slot 37对应什么— 这个有空帮忙问一下内部成员吧,这个是SP686C的卡,我们这边没有固件团队。
另外这个Slot37应该不是物理槽位的37吧,这个会是相对固定的吗?我看pd这个每次AC或者拔盘/换盘后,PD对象是有变更的,不是相对固定的,感觉找寻Slot37的含义是不是没有太大价值?

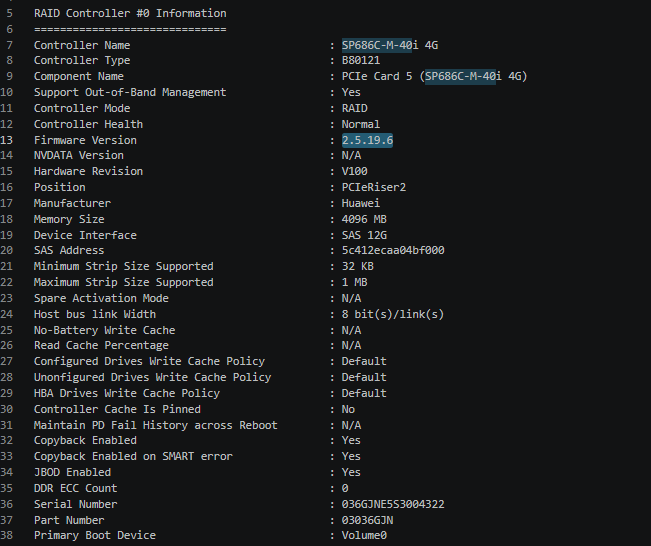
日志里有SP686C出问题的固件版本和型号:

第一次AC后或者硬盘插入 会触发点灯,其他场景是复用历史映射关系, 如果说不能控制,上hardwaresig评个方案吧,是不是要storage内部感知如果在点灯流程中,对于用户的点灯操作进行报错返回,防止影响raid卡点灯定位流程