问题描述
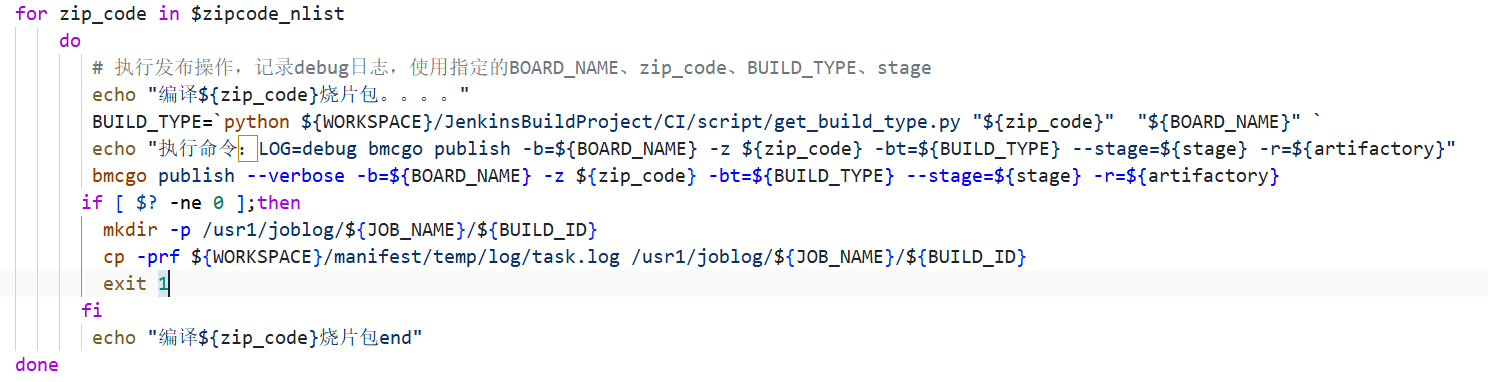
当前在对单板进行编译打包的时候,通过制造编码 循环处理。
问题:制造编码越多,耗时就越久,有的任务执行会超过2小时。
使用并行任务。通过参数区分不同的任务。
答案内容由AI生成,仅供参考:
总结与操作建议
结合您提供的脚本片段,最推荐的优化方案是将串行循环改为并行任务。您可以封装每个 bmcgo publish 调用,并使用 & 符号放到后台执行,最后再使用 wait 命令等待所有任务结束。
示例改造思路(仅供参考):
# 定义函数执行单个构建任务
build_for_zip_code() {
    local zip_code=$1
    # ... (您的原始逻辑) ...
    bmcgo publish --verbose -b=${BOARD_NAME} -z ${zip_code} -bt=${BUILD_TYPE} --stage=${stage} -r=${artifactory}
}

# 循环启动并行任务
for zip_code in $zipcode_nlist
do
    build_for_zip_code $zip_code &
done

# 等待所有后台任务完成
wait

# 检查所有任务的返回码
# ... (错误处理逻辑) ...
通过并行化,尽管单个任务的耗时可能不变,但总构建时间将不再随制造编码数量线性增长,从而有效解决总耗时超过2小时的问题。
根据您提供的上下文信息,针对“通过bmcgo publish编译打包单板耗时很久”的问题,可以通过以下方法显著减少构建时长:
这是文档中指出的最直接有效的优化方法。当前您的脚本是串行循环处理每个制造编码(zip_code),一个完成后才会开始下一个,导致总耗时 = 单个耗时 × 制造编码数量。
bmcgo publish 命令改为后台并行执行。-z 编码、--stage 或输出目录)来区分,避免文件写入冲突。除了上述核心方案,您还可以结合以下方法来进一步缩短整体构建时间:
| 优化策略 | 描述 | 相关引用 |
|---|---|---|
| 使用 Conan 二进制缓存 | 确保已经编译过的依赖包被缓存到本地。这样,在编译后续制造编码时,相同的依赖无需重新编译,能极大减少compile time。 |
关系Conan Binary Cache → compile time 描述了“缓存减少了编译时间”。 |
| 检查构建类型差异 | 在某些场景下,release 构建类型可能因优化等级或额外步骤导致超时。使用 debug 构建类型或许能加快编译速度。 |
参考DC id:2提到:将 build_type 从 release 改为 debug 后,命令可以正常编译。 |
| 使用 Lockfile 机制 | 实施Lockfile可以确保每次构建依赖的版本完全一致,加快并稳定包解析和安装过程,从而减少构建时间滞后。 |
关系Build Time Lag → Lockfile 描述了“实施 lockfile 可以减少构建时间滞后”。 |
结合您提供的脚本片段,最推荐的优化方案是将串行循环改为并行任务。您可以封装每个 bmcgo publish 调用,并使用 & 符号放到后台执行,最后再使用 wait 命令等待所有任务结束。
示例改造思路(仅供参考):
# 定义函数执行单个构建任务
build_for_zip_code() {
    local zip_code=$1
    # ... (您的原始逻辑) ...
    bmcgo publish --verbose -b=${BOARD_NAME} -z ${zip_code} -bt=${BUILD_TYPE} --stage=${stage} -r=${artifactory}
}

# 循环启动并行任务
for zip_code in $zipcode_nlist
do
    build_for_zip_code $zip_code &
done

# 等待所有后台任务完成
wait

# 检查所有任务的返回码
# ... (错误处理逻辑) ...
通过并行化,尽管单个任务的耗时可能不变,但总构建时间将不再随制造编码数量线性增长,从而有效解决总耗时超过2小时的问题。
在同一台宿主机使用并行构建会出现不可预计的失败问题,应采用分发节点,使用不同的宿主机并行构建
那就是通过对每个zip_code分发一台机器或者一个独立容器去编译打包,并行执行,最后将所有产物收集统一上传。这样是正确的吧。
那就是通过对每个zip_code分发一台机器或者一个独立容器去编译打包,并行执行,最后将所有产物收集统一上传。是这样吧。
是的。 不过不需要统一上传。 每个容器执行完就可以独立执行上传,根据manifest.yml里zip_code 指定的归档路径上传到指定的地方,毕竟上传也是耗时的。
好的,了解了,谢谢