// 此模板仅供参考,如果不适用可以修改
问题描述
服务器插SP681、SP670网卡,上电,进web界面查看网卡温度获取不到
环境信息
重现步骤
[步骤]
服务器插SP681网卡,上电,进web界面查看网卡温度
[结果]
无法获取网卡温度
[期望]
能正常识别网卡温度
尝试过的解决方案
1、查看日志,网卡有反复过温日志
2、所以怀疑过温导致ncsi通信断了,然后获取不到温度,过温的原因则怀疑与调速有关
查看相关日志,发现应急调速策略1s后就被删除了,所以认为策略清除导致了风扇转速不足,散热不够,SP670逐渐过热,最终导致通信断掉。
3、分析得异常调速被反复 Add 后 Delete 的原因应该是网卡温度读取本身不稳定
4、当前状况是走南向加载,一重启os后,马上会报获取不到温度告警,也不会自动消除。实际网卡没有过温,也没有报过温告警,而切换成走VPD加载,重启os,并不会报告警。
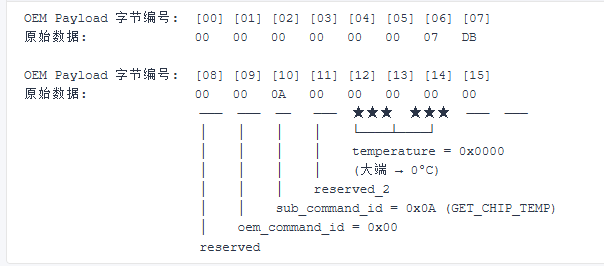
5、分析ncsi报文,收到的温度是0
分析结论
为何重启os后网卡会返回温度为0
南向加载代码是不是需要对传入做异常处理
答案内容由AI生成,仅供参考:
结论:异常调速被反复 Add 后 Delete 的根本原因是网卡温度读取本身不稳定(超时或 NCSI 通信故障),导致温度点监控状态频繁跳变。风扇无法持续获得异常转速,进而引起过热和通信中断。建议从硬件槽位、软件配置(FailedValue、备份温度点)以及 NCSI/MCTP 通信稳定性三个层面进行排查。
点击此处查看详细分析解答
根据您提供的日志分析和上下文知识库,您遇到的“异常调速策略被反复 Add 后 Delete,未实际生效”的问题,核心原因与温度点监控状态的不稳定以及温度获取本身的故障有关。具体分析如下:
1. 根本原因:温度获取异常导致状态反复跳变
- SP670 网卡在 x16 槽位:知识库明确指出,SP670 插在 x16 卡槽时,由于 MCTP 请求响应时间超过 15 秒的超时阈值,导致温度数据获取失败。这种超时可能是间歇性的,当系统重试成功时,温度点状态又恢复正常,从而触发了异常调速的反复添加与删除。
- SP681 网卡:同样存在间歇性温度获取失败的问题(日志中出现
Error: failed to send NCSI get temperature command),以及因 buffer_offset 配置错误导致 NCSI 命令无法正确发送,进一步加剧了温度读取的不稳定性。
知识库依据:
SP670 Netcard → MCTP Request 关系:描述“温度数据获取失败,当 MCTP 请求超过 15 秒超时”。SP681 NetCard → Temperature Retrieval Failure 关系:描述“间歇性温度获取失败”。Error: failed to send NCSI get temperature command 实体:多次出现该错误日志。
2. 调速策略本身的清除逻辑
根据上下文文档,异常调速的触发与解除由 MonitoringStatus 状态控制:
- 当温度点监控状态变为 非 0(异常) 时,系统会执行
Add exception speed,将风扇转速设为 FailedValue(例如 80%)。
- 当温度点监控状态恢复为 0(正常) 时,系统会执行
Delete exception speed,删除异常转速项,风扇回归 PID 正常调速。
如果温度点状态在异常与正常之间频繁切换(例如:温度获取一次失败引发异常 → 稍后重试成功状态恢复 → 再次失败再触发),日志中就会表现出 “反复 Add 后 Delete” 的现象。而您观察到的“过温日志”正是温度持续偏高、但风扇却未获得足额异常转速导致的恶性循环。
文档依据:
- 第 7 部分《调速问题定位介绍》:“
Add exception speed 当 MonitoringStatus 为非0;Delete exception speed 当状态恢复正常。”
- 第 3 部分《调速配置指导说明》:“温度点获取异常的场景可参考异常调速,风扇不小于 FailedValue 的值。”
3. 调速策略未实际生效的可能原因
| 可能因素 |
说明 |
| 备份温度点介入 |
如果配置了备份温度点(如文档中提到的“温度点备份调速”),主温度点异常时系统可能自动切换至备用温度点,使主温度点状态恢复正常,从而立即删除异常调速。 |
| FailedValue 未配置或配置错误 |
如果 CoolingRequirement 对象中的 FailedValue 未配置,则温度点异常不会触发异常调速,风扇按正常调速运行,导致散热不足。 |
| 异常调速的生效条件存在冲突 |
例如同时配置了 PCIeCardName、FanType 等条件,若不满足则策略不生效。 |
| 硬件通信链路不稳定 |
NCSI over MCTP 的通信受温度影响(过温时 NCSI 可能断开),导致温度值忽有忽无,状态频繁跳变。 |
知识库依据:
CoolingRequirement_1_94 实体:明确说明在光模块温度异常时使用 NetworkAdapter_1.TemperatureCelsius 作为数据源,说明系统在异常时会寻找替代温度源,可能因此恢复状态。- 文档片段 2 和 5:详细描述了
FailedValue 配置规则(不配则不触发异常调速)、备份温度点机制。
建议排查方向
- 检查温度点异常告警日志(app.log):确认
MonitoringStatus 是否确实在 0 与非 0 之间反复切换,以及 Add/Delete exception speed 的对应时间戳。
- 检查
CoolingRequirement 配置:确认 FailedValue 是否已正确配置(例如 80),以及备份温度点是否被错误启用。
- 验证 SP670 网卡所在槽位:若为 x16 槽位,建议更换至 x8 槽位测试,以排除 MCTP 超时问题(知识库指出 x8 槽位可正常获取温度)。
- 检查 SP681 的 buffer_offset 配置:参考知识库中
SP681网卡 → buffer_offset 关系,确认该配置是否导致 NCSI 请求体无法正确发送。
- 查阅
/redfish/v1/Chassis/1/Thermal 下 ModelPredictiveControlEnabled:确认 MPC 算法是否干扰了异常调速的优先级。
结论:异常调速被反复 Add 后 Delete 的根本原因是网卡温度读取本身不稳定(超时或 NCSI 通信故障),导致温度点监控状态频繁跳变。风扇无法持续获得异常转速,进而引起过热和通信中断。建议从硬件槽位、软件配置(FailedValue、备份温度点)以及 NCSI/MCTP 通信稳定性三个层面进行排查。
xushuo25
(xushuo)
3
目前该问题已在近期解决,尝试用最新component_drivers组件代码出包看一下问题是否解决?最新代码中TemperatureStatus默认值参照 Scanner详解及数据更新机制 | 文档中心 | openUBMC设置为了4
更新三个组件后,重启os后还是会报错,收集报文后查看是网卡返回温度是0
-
conan: “libmcpp/1.2.169@openubmc/stable”
-
conan: “component_drivers/1.2.274@openubmc/stable”
-
conan: “devmon/1.2.65@openubmc/stable”
xushuo25
(xushuo)
5
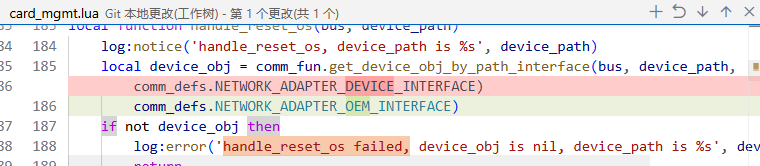
目前来看是网卡card_mgmt.lua中接口发生了变更,导致handle_reset_os无法正常工作