问题描述
双RAID场景,长时间bmc重启或者AC,环境上俩个RAID的信息都获取不到
XC470C-M-8i 4G + XP270-M2
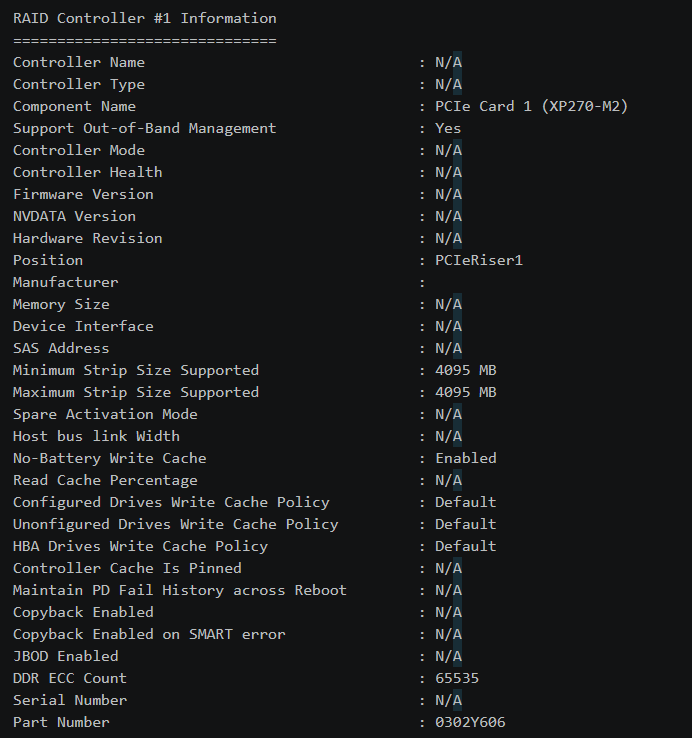
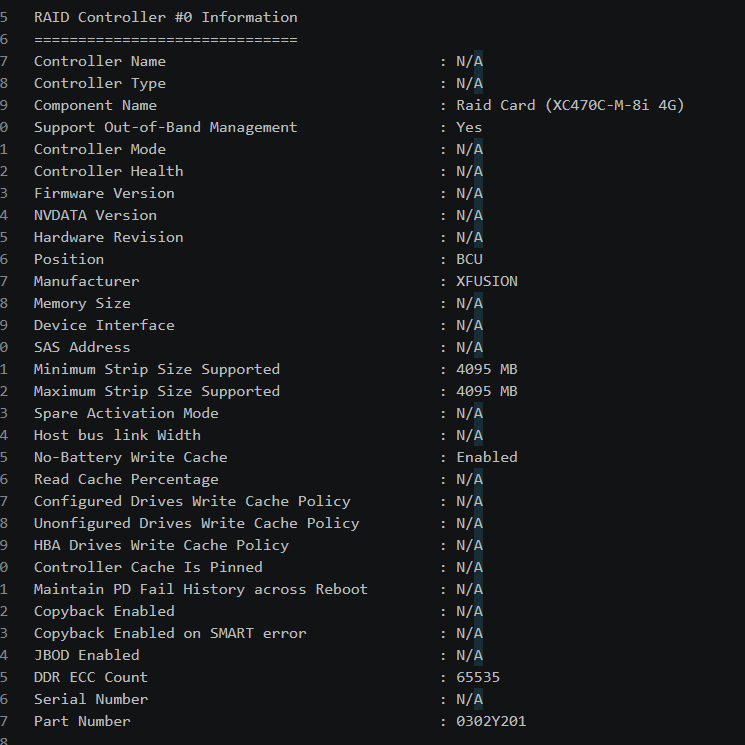
告警

9560-16i + 9560-8i
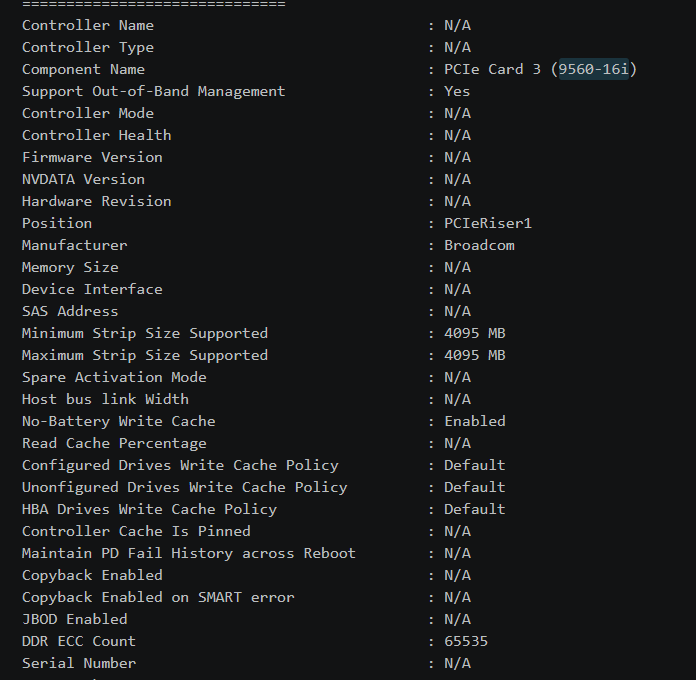
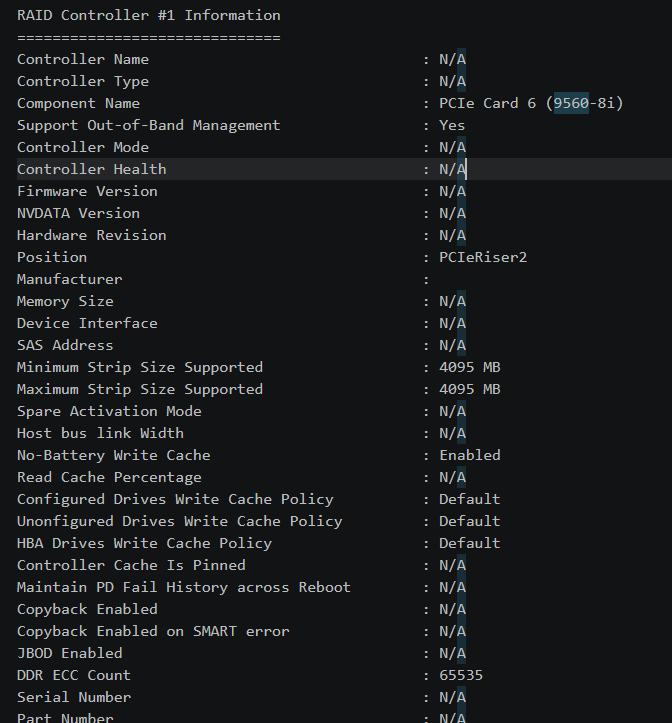
告警

环境信息
- 软件版本:OpenUBMC SP2
重现步骤
双RAID场景,长时间bmc重启或者AC
日志无法上传 需要日志的话 给个邮箱 通过邮箱传递
初步分析
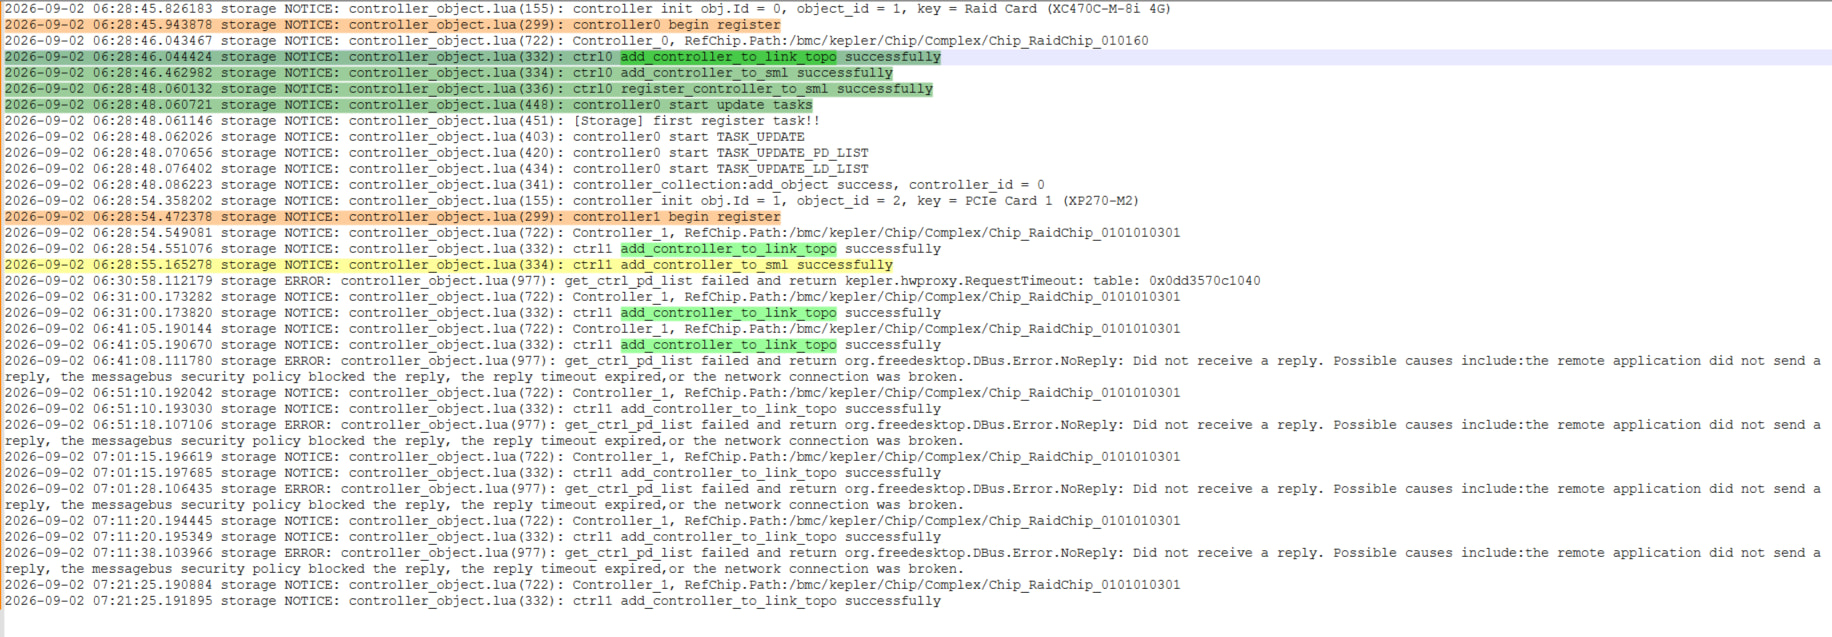
raid0正常完成注册后 raid1注册sml的时候超时
然后raid0的i2c也访问不通
伴随其他路i2c大量报错
答案内容由AI生成,仅供参考:
您遇到的问题是双RAID场景下,BMC重启/AC过程中因组件初始化未完成或中间转发服务挂死导致的概率性信息获取失败。
核心建议:
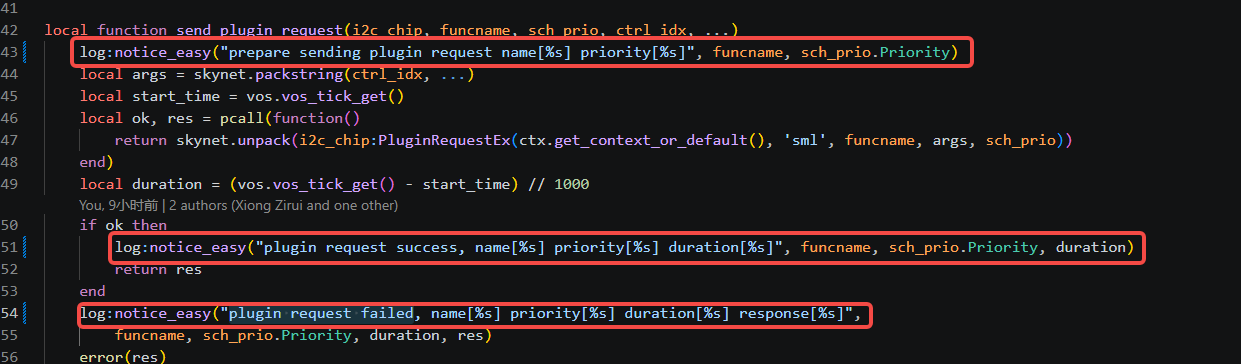
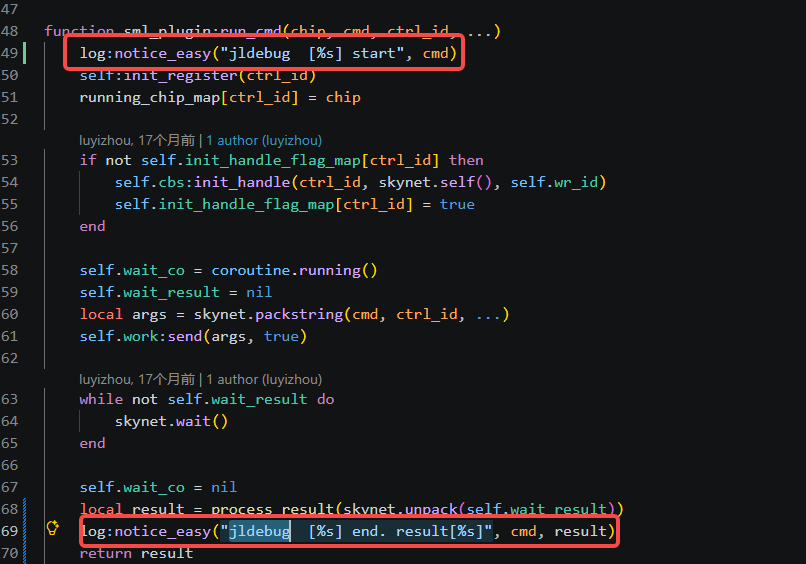
storage组件的add_controller_to_sml流程中增加日志,定位服务卡死点。根据您的问题描述和提供的上下文信息,您遇到的是在双RAID卡场景下,长时间进行BMC重启或AC(交流掉电)循环测试时,以约1/150的低概率出现两张RAID卡信息均无法获取的问题。
结合知识库中高度相关的案例分析(如920BS双RAID场景,AC自动化时概率性出现获取不到RAID卡信息,概率1/100),以下是对您问题的综合分析与解决方向:
该问题并非简单的硬件故障,而是一个概率性的软件时序问题。核心机制如下:
storage组件会调用独立的 smld lua service 来转发请求。在AC或BMC重启的瞬间,如果时序不当,这个转发服务可能会挂死。N/A。根据知识库中的相关记录,导致该时序问题的潜在原因包括:
ssdp、file_transfer等服务启动检查失败),此时BIOS已发起信息查询请求,导致读取超时或失败。framework.log中记录了BMC重启事件,且存在组件(如ssdp、file_transfer)启动检查失败的日志,这可能导致BMC功能尚未就绪时便开始处理硬件信息请求。基于知识库中类似问题的成功解决方案,建议按以下步骤排查:
topic 6551中的分析结论,问题集中在 Controller_1 执行 add_controller_to_sml() 的过程中。self:add_controller_to_sml() → sml.register_controller-> CMD.register_controller 链路中添加详细日志,确认smld服务具体卡在哪个函数,以便确认是MCTP通信问题还是Lua服务挂死问题。file_transfer、ssdp)在重启后未完全恢复,导致信息读取失败。[优化丝印获取时间](https://gitcode.com/openUBMC/bios/pull/62/commit),通过提前丝印获取时间,减少因超时导致的内存、RAID卡等信息加载不上的问题。您提到“日志无法上传,需要日志给个邮箱”,知识库中的相关案例显示,社区支持人员(如zll)通常需要通过 app.log 和 framework.log 来分析此类问题。关于邮箱联系方式,知识库中并未提供任何具体的邮箱地址。建议您在OpenUBMC社区论坛中,直接联系该问题的分析人员(如您帖子中的回复者)获取传递方式,或查看论坛私信功能。
您遇到的问题是双RAID场景下,BMC重启/AC过程中因组件初始化未完成或中间转发服务挂死导致的概率性信息获取失败。
核心建议:
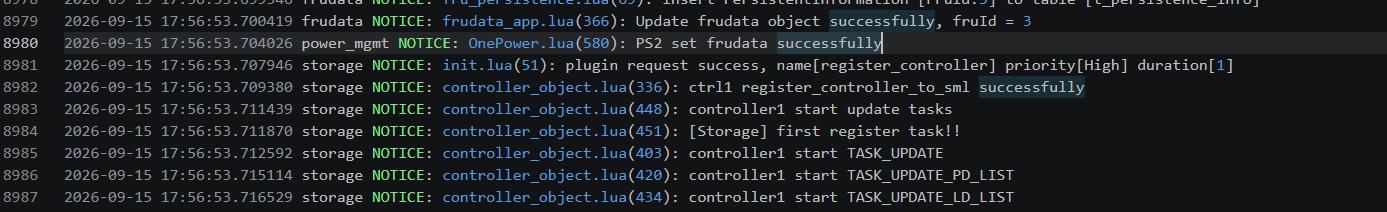
storage组件的add_controller_to_sml流程中增加日志,定位服务卡死点。加打印后复现一键收集
KunLun2280V2_2102315PDMD9S4100003_20260915-1852.tar.gz (16.7 MB)
这个链接的问题已经解了 这次的问题跟MCTP没有关系
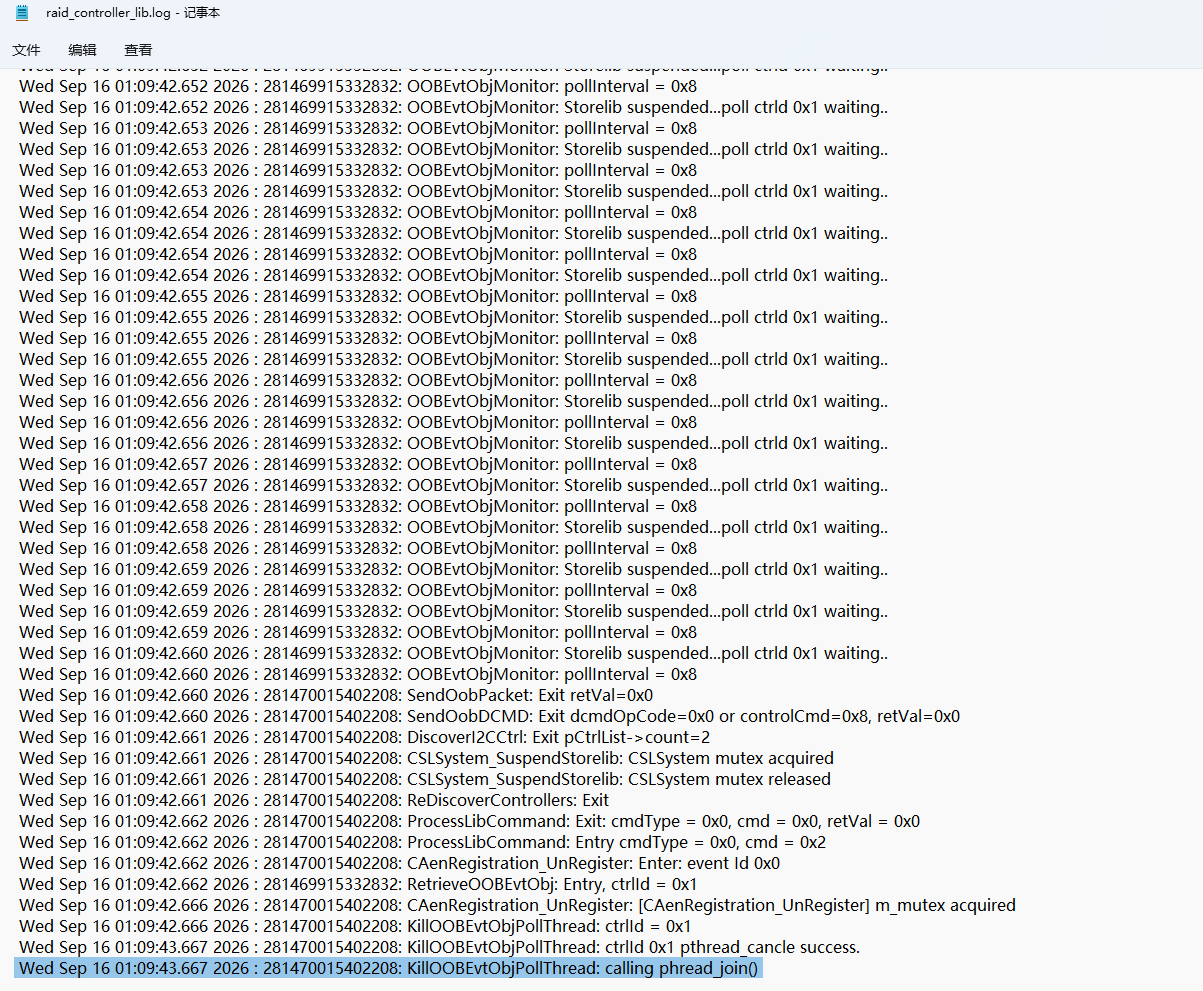
打开了 storelib 详细日志,最终死在了一处 pthread_join ,怀疑是 storelib 内部有死锁的情况
KunLun2280V2_2102315PDMD9S4100003_20260916-0829.tar.gz (16.9 MB)
KunLun2280V2_2102315PDMD9S4100003_20260916-0829.tar.gz (16.9 MB)
调整了raidlib_conf.ini中的日志级别后的再次复现日志