E610网卡有mctpd请求超时日志刷屏

问题描述

os上电情况下,debug日志有mctpd刷屏,1分30秒左右1次,必现

2026-07-15 15:31:11.981422 mctpd ERROR: mctp_engine.lua(385): [System1]mctp_engine: request timeout
2026-07-15 15:32:38.077518 mctpd ERROR: mctp_engine.lua(385): [System1]mctp_engine:request timeout
2026-07-15 15:34:04.064346 mctpd ERROR: mctp_engine.lua(385): [System1]mctp_engine:request timeout
2026-07-15 15:35:30.184573 mctpd ERROR: mctp_engine.lua(385): [System1]mctp_engine: request timeout
2026-07-15 15:36:57.409661 mctpd ERROR: mctp_engine.lua(385): [System1]mctp_engine: request timeout
2026-07-15 15:38:25.778996 mctpd ERROR: mctp_engine.lua(385): [System1]mctp_engine: request timeout
2026-07-15 15:39:53.039582 mctpd ERROR: mctp_engine.lua(385): [System1]mctp_engine:request timeout

环境信息

  • 操作系统:[如 Ubuntu 24.04]

  • 软件版本:OpenUBMC0330

  • 硬件配置:[如 CPU、内存等]

重现步骤

  1. [第一步]

  2. [第二步]

  3. [第三步]

期望结果

os上电情况下,debug日志没有mctpd刷屏

实际结果

os上电情况下,debug日志有mctpd刷屏

尝试过的解决方案

调整日志等级,显示等待时长为15s,排除等待时间不足120+6ms。

分析结论
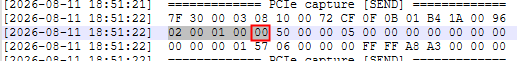
image

询问Intel,给的回复是图中该位报文不能从00开始,发送00的报文都没有回复,报文由mctpd闭源组件仓发送,请问这个算问题么?这个报文起始位能调么?

答案内容由AI生成,仅供参考:

总结与建议

  1. 定位方向

    • 结合 tracemctp 和 tcpdump 抓取完整收发报文,检查响应是否合法(CRC、长度、类型字段)。
    • 验证网卡是否正常响应 discovery 报文,确认链路硬件正常。
    • 对比协议规范,确认发送的请求报文各字段(尤其是起始标识)符合标准。
  2. 缓解措施

    • 若该日志仅用于协助定位且非关键,可参照已有方案将 mctp_engine.lua 中超时错误的日志级别从 ERROR 降为 DEBUG,减少刷屏。
    • 调整超时数值(如从15000ms增至30000ms),但需确认对端设备实际响应时间。
  3. 进一步处理

    • 由于 mctpd 为闭源组件,报文构造逻辑您无法直接修改,必须联系组件维护方。
    • 在社区或工单中提供完整日志和抓包数据,推动开发方修复起始字段不合规问题。
点击此处查看详细分析解答

根据您提供的日志信息和上下文知识库,对您的问题分析如下:

问题现象及根因定位

日志中反复出现的 mctpd ERROR: mctp_engine.lua(385): [System1]mctp_engine: request timeout 表明 MCTP 引擎请求超时。
根据知识库中的信息:

  • mctpd 是 OpenUBMC 中负责 MCTP 协议管理的核心守护进程,它处理端点注册、消息路由和请求超时监控。
  • mctp_engine.lua 是 MCTP 引擎的 Lua 实现,负责发送/接收消息、记录超时错误。
  • 超时阈值默认为 15000 毫秒(15秒),但您的日志间隔约1分30秒,说明每次请求均未在限定时间内获得正确响应,触发了重试和日志打印。

可能的原因(根据上下文知识)

可能原因 说明
协议编码问题 若 BMC 已发出报文但未收到合法响应,可能是响应报文结构异常导致被 mctpd 静默丢弃(如 CRC 校验失败、载荷大小不匹配、分片序号错误等)。参考文档《mctpd使用说明》中的常见关键字:nvme_protocol: unmatch crc、ncsi_protocol: check sum、mctp_protocol: unexpected fragment size 等。
硬件/链路问题 MCTP 端设备(如网卡)未正确响应 discovery 报文,或 PCIe/SMBus 链路异常导致通信中断。
超时设置不当 尽管您已将超时调整为15s,但若对端设备响应超过此值仍会超时。
闭源组件行为 您提到 Intel 反馈“发送的报文起始位不能为00,否则无回复”,若 mctpd 闭源组件构造的请求报文起始字段为00,则属于协议合规性问题,会导致对端设备忽略请求,从而引发超时。

回答您的两个问题

1. 这算问题吗?

是的,这是一个需要关注的问题。

  • 它表明 MCTP 通信持续失败,导致 BMC 无法正常获取网卡信息(如温度、配置等)。
  • 高频的 error 日志刷屏占用系统资源,影响日志可读性和问题排查效率。
  • 若该 error 日志仅为调试辅助,可参考已有案例(如“OS下电后日志刷屏分析”)将日志降级为 debug 级别;但根本原因仍需修复。

2. 报文起始位能调整吗?

根据现有知识库,未提供调整报文起始位的配置或方法。

  • 报文结构由 mctpd 闭源组件直接构造和发送,其内部实现不对外公开。
  • 知识库中仅指出“若收发均有打印仍超时,需分析响应报文结构问题”,未涉及起始字段的可调整性。
  • 建议您向 mctpd 开发团队(或 Intel 相关支持) 确认:
    • 闭源代码中是否存在协议规范违规(如起始位固定为00)。
    • 是否有补丁或新版本修正该行为。
    • 是否可以提供临时规避措施(例如修改 medium_type、bmc_eid 等参数影响报文构造,但需开发方指导)。

总结与建议

  1. 定位方向

    • 结合 tracemctp 和 tcpdump 抓取完整收发报文,检查响应是否合法(CRC、长度、类型字段)。
    • 验证网卡是否正常响应 discovery 报文,确认链路硬件正常。
    • 对比协议规范,确认发送的请求报文各字段(尤其是起始标识)符合标准。
  2. 缓解措施

    • 若该日志仅用于协助定位且非关键,可参照已有方案将 mctp_engine.lua 中超时错误的日志级别从 ERROR 降为 DEBUG,减少刷屏。
    • 调整超时数值(如从15000ms增至30000ms),但需确认对端设备实际响应时间。
  3. 进一步处理

    • 由于 mctpd 为闭源组件,报文构造逻辑您无法直接修改,必须联系组件维护方。
    • 在社区或工单中提供完整日志和抓包数据,推动开发方修复起始字段不合规问题。

以上分析均基于提供的知识图谱、文档块及搜索结果,未添加任何外部假设。若需更详细的排查步骤,可参考知识库中的《mctpd使用说明》及《通过tcpdump抓取NCSI报文》文档。

mctpd现在开源了,调整是可以调整。

这个因为报文起始位是00,没有回复,导致mctpd日志刷屏的问题,之前没有出现过么?你们那边能帮忙修改下么?

内部反馈下

已在mctpd 1.130.13版本 修复,mctpd:MCTP protocol driver for openUBMC - AtomGit