// 此模板仅供参考,如果不适用可以修改
问题描述
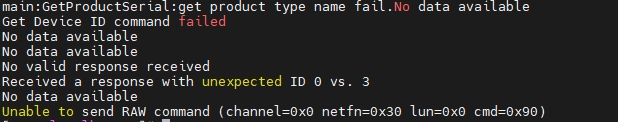
920bs机型部分机器装备测试过程中出现异常,分析发现在开始测试时获取不到BMC相关信息,OS已经启动完,但是BMC出现异常。
复现概率如下,两批设备
8台,异常数量:3台,概率:38%
45台,异常数量:9台,概率:20%
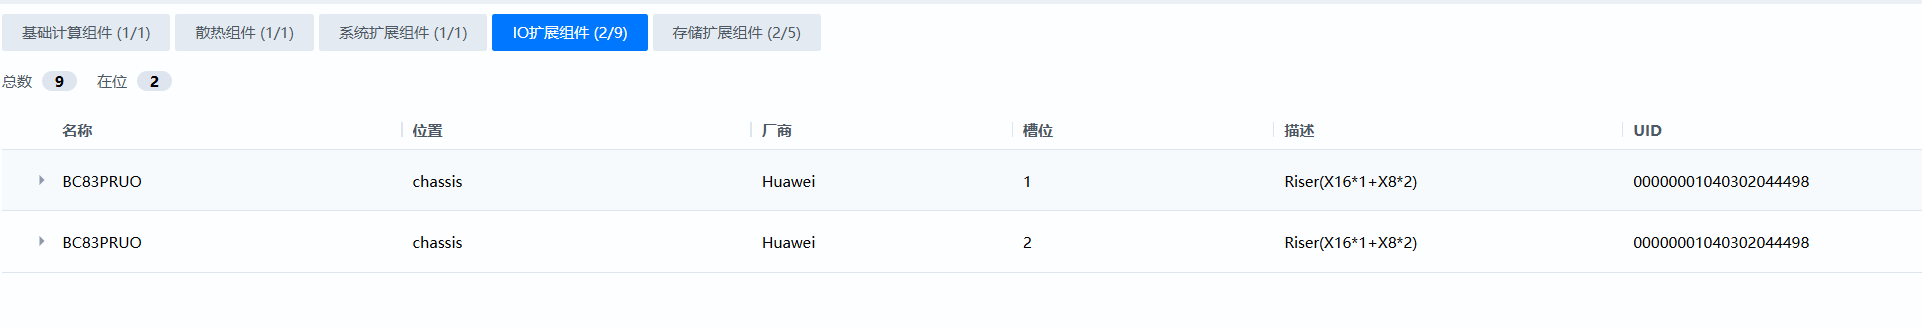
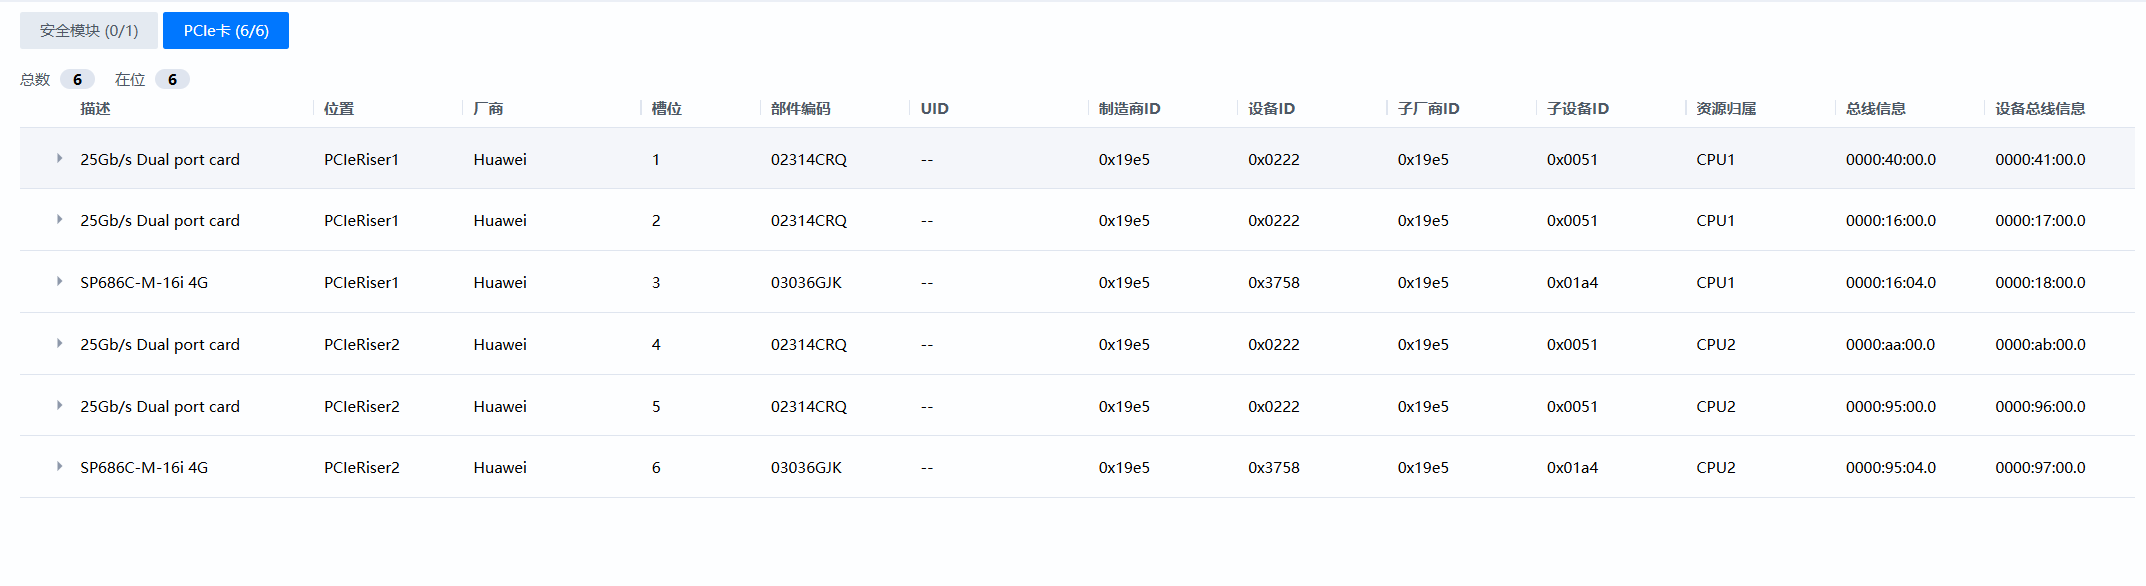
配置:双raid卡 SP686C-M-16i 4G
KunTaiR722K2_KS008310S814100027_20260817-1230.tar.gz (8.0 MB)
环境信息
期望结果
BMC启动正常
分析结论
通过日志分析,发现BMC进行了强制重启,BMC reset cause = 16
从日志看到了:
2026-08-17 05:44:10.705238 maca ERROR: base.lua(249): [storage] continuously offline 5 time within 10 minutes, rebooting…
2026-08-17 05:44:10.348966 [:00000010] hardware: attempt to call a nil value
连续五次后触发重启。
答案内容由AI生成,仅供参考:
总结
本次问题属于 BMC 异常重启(原因码 0x10),直接诱因是 storage 组件连续离线并触发 maca 看门狗保护性复位,同时 hardware 组件出现空值调用错误。根源可能在于:
- Storage 组件初始化或通信存在时序缺陷;
- 硬件访问失败导致对象状态异常;
- 系统重启策略未合理处理组件启动阶段的不稳定状态。
建议优先升级到 26.03 或更高版本(参考 Document Chunks 8 中 330 基线的修复),并对照 framework.log 和 hardware 日志定位具体崩溃点;若问题持续,可向 OpenUBMC 社区提交一键收集日志以获得进一步支持。
点击此处查看详细分析解答
根据您提供的问题描述和日志信息,结合知识库中的知识图谱与文档内容,现对 OpenUBMC 2512 版本强制重启 BMC(复位原因码 0x10) 的问题进行分析与回答。
问题概要与原因码含义
您报告的日志显示 BMC 强制重启,复位原因码为 0x10(十进制 16)。在 OpenUBMC 系统中,事件码 0x1A00006F 会关联不同的复位原因码,其中:
- 0x2:通常与 UID 按钮长按复位、Web 正常重启或内核 panic 相关(参见 [知识图谱-事件
The OpenUBMC Is Reset With The Cause Code Of 0x2] 及论坛回复)。
- 0x10:表示 BMC 因组件异常或服务故障而重启,常见于服务进程崩溃、看门狗超时或系统初始化失败等场景(参见 [知识图谱-事件
The OpenUBMC Is Reset With The Cause Code Of 0x10])。
论坛成员 linyao 在相关问题中提到:“code 是 0x10 可以看下是否有组件异常重启,检查一下 framework.log”(参考 Document Chunks 1)。此外,社区在 AC 测试复现类似问题,日志显示 skynet 进程不断崩溃并产生 core dump,最终导致看门狗超时触发硬件重启,上报原因码 0x10(参考 Document Chunks 3)。
您日志中的关键线索
您提供的日志包含两条关键信息:
maca ERROR: base.lua(249): [storage] continuously offline 5 times within 10 minutes, rebooting...
hardware: attempt to call a nil value
- storage 组件连续离线:
storage 组件在 10 分钟内连续 5 次被识别为离线,触发 maca 框架的保护性重启机制。
这与知识库中的 BMC Abnormal Restart(因服务失败导致系统不稳定而重启)以及 init service failed(关键初始化服务启动失败)概念一致。
attempt to call a nil value:表明在硬件访问过程中出现了空值调用,这可能是硬件状态读取失败、通信中断或对象未正确初始化的表现。
此类错误常与 BMC.Error.Uncnlow(I2C 读取超时或硬件内部错误)有关,需要硬件层面排查(论坛用户 lisongwei 也强调过硬件协调与调试的必要性)。
推荐排查方向
结合知识库中的案例和现有分析,建议按以下步骤深入定位:
1. 检查 framework.log 与组件日志
- 查看 framework.log 中与
storage 组件相关的详细错误,确定离线原因(如通信超时、对象创建失败、数据持久化问题)。
- 检查
hardware 组件日志(例如 general_hardware 或 storage 组件日志),定位出现 nil 值的具体函数和上下文。
在参考文档 Document Chunks 10(NVMe 盘信息丢失问题)中,类似的 nil value 错误出现是因为 NVMe 对象创建失败,可能与初始化时序有关。
2. 验证硬件与固件交互
- 确认 NCSI 线缆、OCP 卡、电源等硬件连接是否稳定(参考 Document Chunks 8 四电源环境重启 BMC 问题)。
- 检查是否存在 I2C 总线故障或设备未就绪导致的空指针访问(参考知识图谱中 BMC.Error.Uncnlow 的分析)。
3. 关注社区已修复的同类问题
- Document Chunks 8 中提到,四电源环境下概率性电源冗余丢失告警已在 330 版本 修复,涉及模块间启动时序调整。
您当前使用 2512 版本,建议升级到包含相关修复的版本。
- Document Chunks 5(BBU 告警复位问题)提供了 CSR 配置属性
InvalidReadingIgnore 和 InvalidReading 的使用方法,类似机制可能适用于解决告警误触发或异常复位。
4. 分析概率性与批次性因素
- 您提供的数据显示异常概率约为 20%~38%,这可能与 硬件批次差异 或 启动时序竞争 有关。
社区用户 昆仑太科_安阳阳 也曾报告过重启 BMC 解决临时状态问题的案例(重启可刷新状态),但若根本原因未解决,重启仍会反复发生。
参考链接与资源
- 知识库事件:
The OpenUBMC Is Reset With The Cause Code Of 0x10BMC Abnormal Restartinit service failed
- 论坛相关讨论:
- 社区已发布的修复:
总结
本次问题属于 BMC 异常重启(原因码 0x10),直接诱因是 storage 组件连续离线并触发 maca 看门狗保护性复位,同时 hardware 组件出现空值调用错误。根源可能在于:
- Storage 组件初始化或通信存在时序缺陷;
- 硬件访问失败导致对象状态异常;
- 系统重启策略未合理处理组件启动阶段的不稳定状态。
建议优先升级到 26.03 或更高版本(参考 Document Chunks 8 中 330 基线的修复),并对照 framework.log 和 hardware 日志定位具体崩溃点;若问题持续,可向 OpenUBMC 社区提交一键收集日志以获得进一步支持。
storage组件异常退出导致,可以看下app.log有什么storage的报错